机制
书名只敲一遍,几个源同时答
搜索不是把结果抓回来汇总成一份,而是逐源问、逐源回,所以速度取决于最慢的那个。
点进输入框敲字,客户端会把关键词同时发给清单里所有开着的源。每个源自己决定怎么匹配:有的按标题前缀,有的按作者名,有的把简介也纳进来。所以同一个词在不同源下命中的范围并不一样,数量差几倍也正常。
结果是一段一段回来的,先答完的源先显示,不必等全部到齐。清单越长,等最慢那一个的时间就越长;这也是把不用的源关掉的实际好处——不是省流量,是省等待。
每一条结果都带着来源,不会混成一锅。同一本书在三个源里都有,就会看到三条并列的记录,各自的封面、章节数、更新时间分开显示。这个设计有点啰嗦,但少了它就没法判断该点哪一条。
点开其中一条,进的是那个源下的作品页,之后的章节列表、下载、阅读都只在这个源里进行。想换源读同一本,得回到结果页点另一条,不会自动跟着跳。
分辨
结果排序与同名作品
书名一样不代表内容一样,判断顺序比排序本身更要紧。
-
01
先看章节数
同名不同源,章节数差出几十话很常见。连载中的作品,章节多的那个一般更跟得上进度。
-
02
再看更新时间
章节数接近时,看最近一次更新是哪天。停在半年前的多半是源不再维护,换一条更稳。
-
03
然后看作者与标签
译名相近的两本书很容易混。作者名和标签对得上,基本就是同一部;对不上就是撞名。
-
04
最后才看封面
封面是最不可靠的一项,同人图和重制版都会换封面。用它做最后确认,而不是第一判断。
看图
界面预览
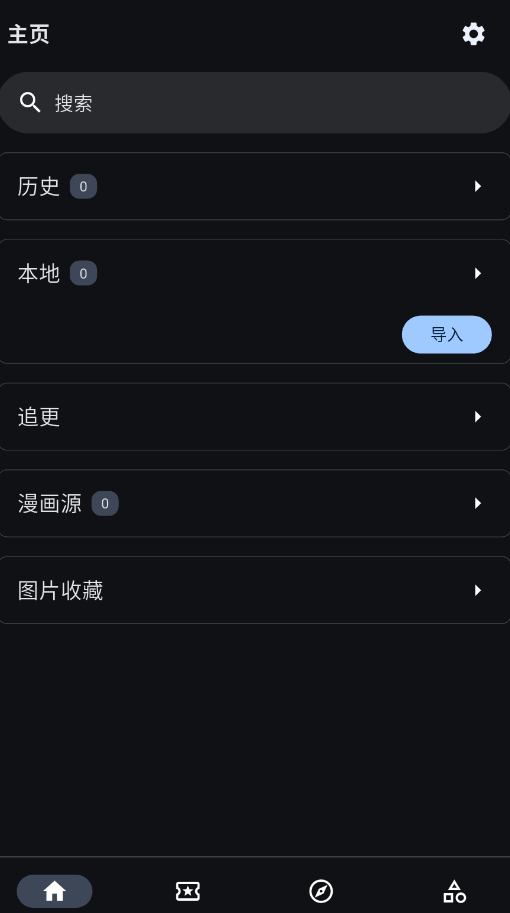
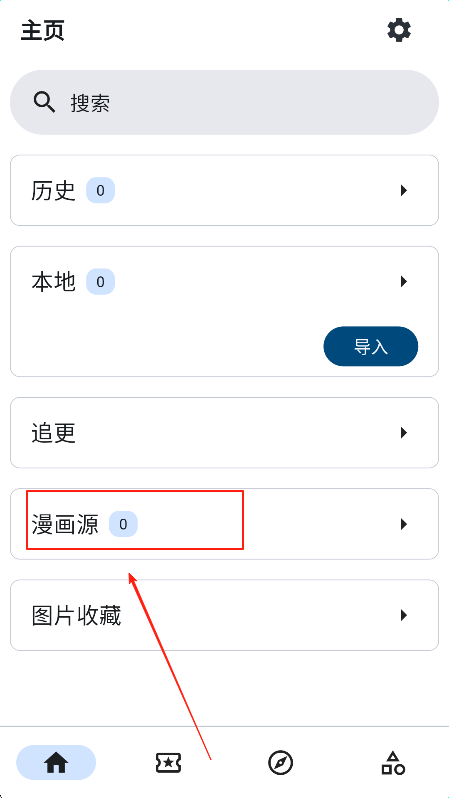
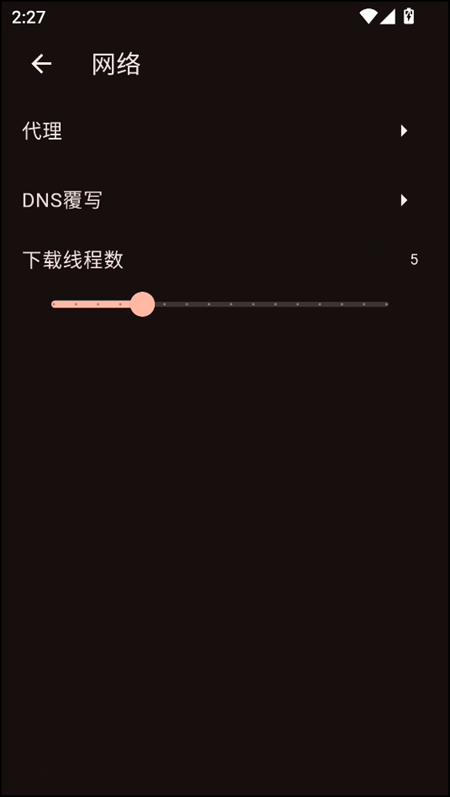
输入框、搜索历史、网络分组,三处合起来能说明一次搜索卡在哪。
筛选
筛选与标签各管什么
两个东西名字像,作用完全不同,混用会白费工夫。
筛选是搜索之后的动作,作用范围是这一次的结果。它按后面的源、更新时间、完结状态把列表裁短,不重新发起请求。换句话说,筛掉的东西还在结果里,只是暂时不显示,改回来立刻恢复。
标签是作品自带的属性,由源在返回数据时给出,可以是热血、悬疑,也可以是连载状态。它不是搜索框的替代品:同一个标签在 A 源可能有几百本,在 B 源一本都没有,取决于源自己怎么标。
想按题材找书,用标签比用关键词更省事,但要接受不同源标签体系不统一这件事。想精确找到某一本,还是用书名搜,再去结果里挑章节数最多的那条。
如果结果里出现明显不相关的内容,先别急着怀疑关键词。多半是某个源把简介也纳入了匹配,换个更完整的书名再搜一次,噪音会少很多。